端侧AI芯片的产业叙事正在换挡。过去两年,峰值TOPS几乎成了唯一的宣传抓手;而到了今年秋季的产业观察窗口,越来越多的方案商开始把「每瓦有效算力」摆到台面上。天天看球行业资讯栏目梳理公开资料后发现,这一转变并非话术游戏,而是端侧场景的物理约束决定的——功耗墙、散热墙和成本墙同时收紧,峰值数字的边际意义正在下降。
一、峰值算力为何不再是唯一标尺
结论先行:端侧设备的算力上限由散热能力而非芯片设计决定,因此峰值TOPS只能说明「瞬时能做多少」,无法回答「持续能做多少」。
以智能座舱与移动终端为例,芯片长时间运行在封闭空间内,结温上升会触发降频。公开的芯片规格书通常标注峰值算力与典型功耗,但两者的测试条件并不一致,直接相除得到的能效比往往偏乐观。天天看球在整理方案资料时注意到,部分厂商已开始在数据手册中补充「持续算力」口径,这是一个值得关注的行业信号。
- 峰值算力适合描述单帧推理的响应上限,适合营销对比;
- 持续算力更贴近实际负载,适合工程选型;
- 能效比需要标明测试模型、批大小与散热条件才有可比性。
二、制程节点与封装形态如何影响能效
结论先行:制程进步带来的能效收益正在放缓,先进封装与近存计算成为新的增量来源。
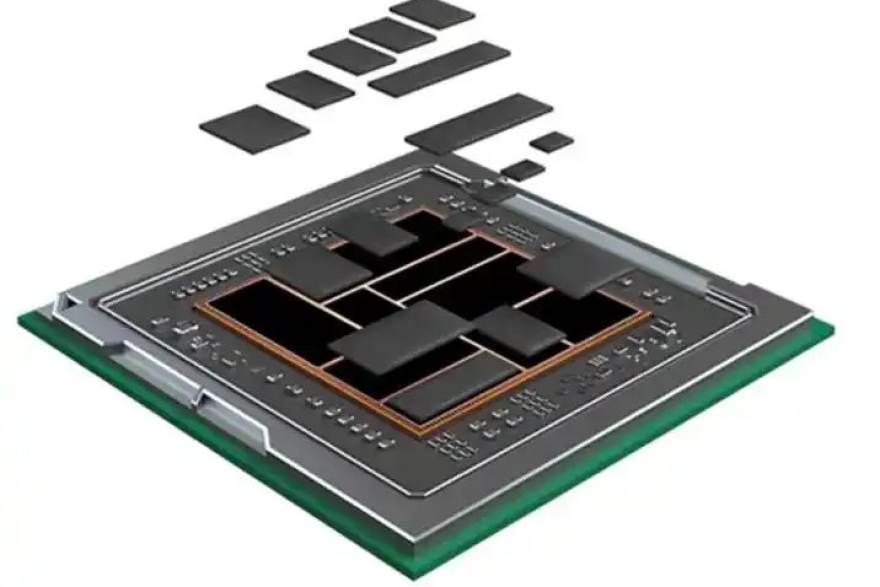
从公开的产业路线图看,制程微缩在逻辑密度上的收益依然存在,但漏电与成本的上升让单位算力的能效改善幅度收窄。行业研究机构的公开白皮书普遍认为,封装层面的创新——包括多芯片集成、高带宽存储靠近计算单元——在端侧同样开始显现价值。天天看球观察到,部分面向边缘推理的方案已采用计算芯粒加存储芯粒的组合,用封装换带宽,用带宽换能效。
需要提醒的是,封装方案的散热路径更复杂,热设计功耗的核算方式与传统单芯片不同,选型时不能直接套用旧口径。
三、真实能效的核算框架与选型建议
结论先行:评估端侧AI芯片应建立「场景—模型—功耗—成本」四维框架,而非单看一项指标。
一个可操作的核算路径是:先确定目标模型的参数量与精度要求,再匹配芯片的存储带宽与片上缓存,随后在目标散热条件下测量持续吞吐,最后折算整机成本。天天看球建议读者在查阅公开资料时,优先关注厂商是否披露测试模型名称、批大小、环境温度与降频策略,这些信息决定了数字的可比性。
- 模型维度:同一颗芯片跑不同模型的能效差异可达数倍;
- 功耗维度:区分芯片功耗与整机功耗,后者更贴近用户体验;
- 成本维度:把存储、电源管理与散热计入总拥有成本;
- 生态维度:工具链成熟度直接影响模型迁移的实际工作量。
从产业趋势看,端侧AI芯片的竞争正在从「堆算力」转向「算得准、算得省、算得稳」。天天看球将持续跟踪公开的规格披露与方案动态,为读者整理可核验的条目。对从业者而言,读懂算力账本,比记住一个TOPS数字更有长期价值。
网友评论
来自读者的观点与讨论
持续算力这个口径太重要了,我们做车载项目被峰值参数坑过,实测降频后差距明显。
封装换带宽这个思路在边缘盒子产品上确实能看到,但散热设计要重做,不是换个芯片就行。
建议补充一下不同精度下的能效对比,INT8和FP8的差异在实际部署里挺关键。
四维框架挺实用,尤其是整机功耗那一条,客户经常只看芯片功耗。
天天看球这个栏目整理得比较克制,没有堆数字,适合做选型前的入门参考。